Proxy web scraping
Proxy Web Scraping Premium
Rotating Residential · Static ISP · Nhắm mục tiêu theo quốc gia · Xác thực thông tin đăng nhập
- Định tuyến các bộ thu thập trang công khai đã được phê duyệt qua các địa chỉ proxy riêng
- Xoay địa chỉ qua các URL, trang và lịch làm mới được giới hạn
- Thu thập dữ liệu công khai theo địa phương với nhắm mục tiêu theo quốc gia
- Sử dụng một địa chỉ được gán khi một nguồn cơ sở lặp lại cần tính liên tục
Tại sao dùng proxy Web Scraping
Proxy cho Web Scraping là gì?
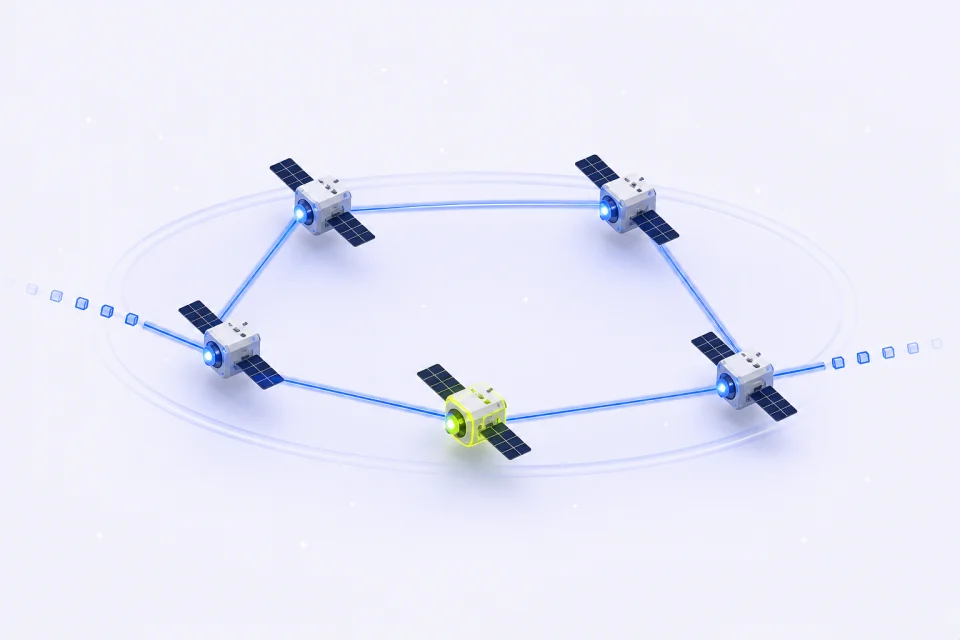
Một proxy cho web scraping hoạt động như một trung gian giữa bộ thu thập được phê duyệt và một trang web công khai. Nó cung cấp một địa chỉ IP khác cho yêu cầu thay vì sử dụng địa chỉ mạng thông thường của người vận hành.
Một nhóm dữ liệu web có thể sử dụng định tuyến proxy cho các trang sản phẩm công khai, tìm kiếm, danh mục, thư mục, bài viết hoặc các trang được phê duyệt khác khi các trường cần thiết, URL, quốc gia, tần suất làm mới và điều kiện dừng được xác định trước.
Truy cập Rotating Residential phù hợp với việc thu thập giới hạn cần các yêu cầu độc lập trên các quốc gia có sẵn. Static ISP phù hợp với nguồn được ủy quyền thực sự hưởng lợi từ một địa chỉ được gán trong các phiên lặp lại.
Ví dụ, một người thu thập giá có thể yêu cầu danh sách mặt hàng chuẩn thông qua các tuyến đường cư dân luân phiên, xác thực mọi phản hồi và trường dữ liệu được trích xuất, lưu trữ các trang không thay đổi, dừng khi bị từ chối lặp lại và cách ly các mẫu không mong muốn để xem xét.
Các trường hợp sử dụng proxy cho Web Scraping
Cách Hoạt Động Của Proxy Trong Web Scraping
Sử dụng định tuyến proxy như một lớp kiểm soát trong hệ thống dữ liệu công khai được phê duyệt với phạm vi, nhịp độ, xác thực, ngân sách lưu lượng và điều kiện dừng rõ ràng.
Bảo Vệ Nhận Diện Trình Thu Thập
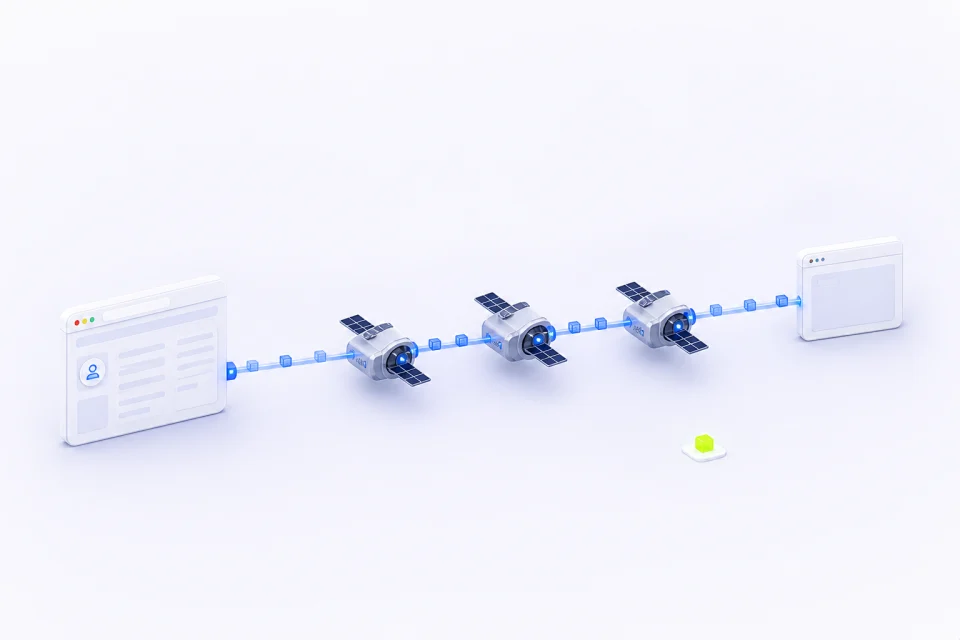
Một proxy giữ địa chỉ mạng bình thường của người thu thập ra khỏi đường dẫn yêu cầu trang công khai được phê duyệt và cung cấp chứng thực proxy riêng.
IPMusk: giữ thông tin xác thực proxy, dữ liệu tài khoản nguồn, và nội dung trang nhạy cảm khỏi nhật ký và ảnh chụp màn hình.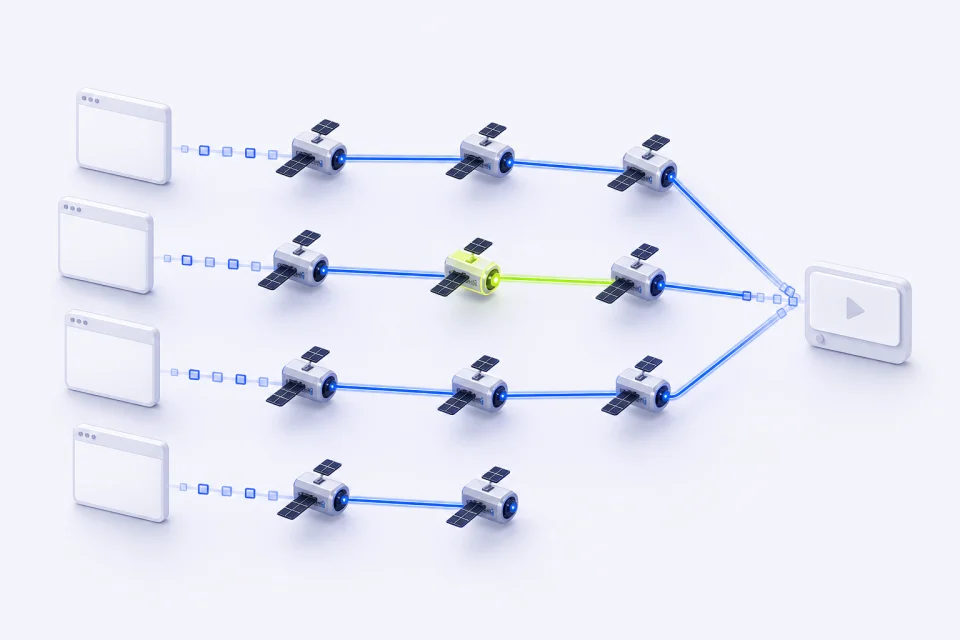
Luân Phiên IP Qua Các Yêu Cầu Riêng Biệt
Luân phiên mặc định tách các yêu cầu URL và phân trang riêng biệt trong một công việc thu thập giới hạn thay vì gửi mọi yêu cầu qua một địa chỉ.
IPMusk: đặt độ đồng thời, nhịp độ, thời gian chờ, giới hạn thử lại và đường dẫn dừng ngay lập tức theo hướng thận trọng.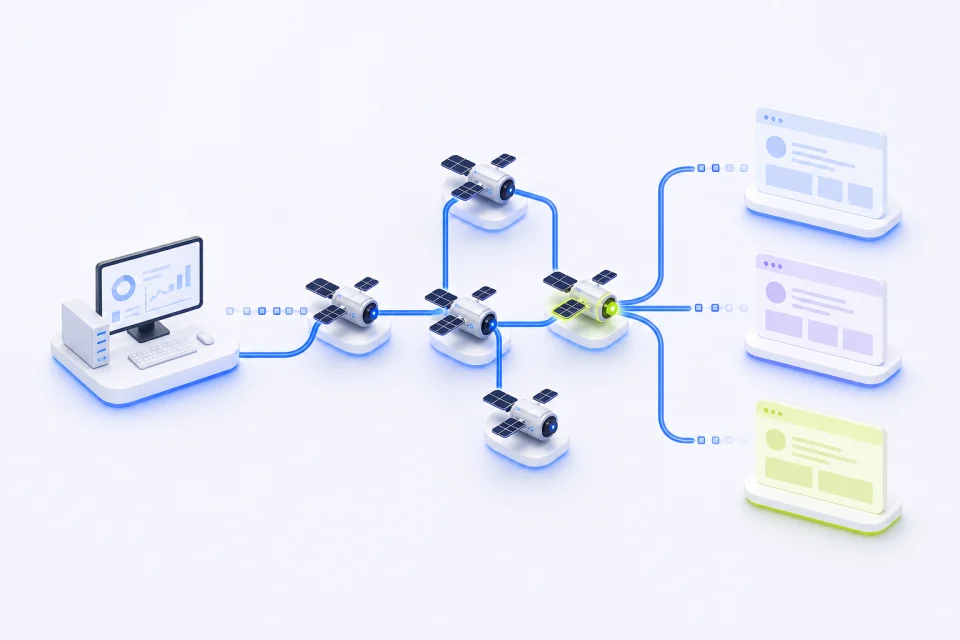
Nhắm Đến Các Quốc Gia Cụ Thể Cho Dữ Liệu Địa Phương
Các tuyến cấp quốc gia giúp so sánh giá công khai, danh mục, trang tìm kiếm, thông báo và nội dung khu vực được phê duyệt khi các đầu vào trình duyệt khác vẫn được kiểm soát.
IPMusk: chọn quốc gia và bang; việc nhắm mục tiêu thành phố, ASN hoặc nhà mạng không được cung cấp.
Duy Trì Chất Lượng Dữ Liệu Đo Lường
Chỉ trạng thái phản hồi là không đủ: xác thực các trường bắt buộc, mẫu trang, trạng thái quốc gia, các bản sao, phiên bản bộ phân tích và dấu thời gian nguồn trước khi chấp nhận một bản ghi.
IPMusk: đo lường các bản ghi hữu ích trên đơn vị lưu lượng, không phải khối lượng yêu cầu thô hay số lần phản hồi.Các tính năng proxy Web Scraping của IPMusk
Điểm nổi bật của Proxy Web Scraping IPMusk
Hai sản phẩm được tách biệt rõ ràng bao phủ các yêu cầu nghiên cứu luân phiên và các luồng công việc với địa chỉ được chỉ định ổn định mà không trộn lẫn hành vi phiên hoặc mô hình tính phí của chúng.
| Tính năng | IPMusk | Phù hợp nhất |
|---|---|---|
| Tùy chọn proxy | Proxy dân cư luân phiên ISP tĩnh | Dữ liệu công khai và môi trường được gán ổn định |
| Kiểm soát vị trí | Chọn theo quốc gia | So sánh trang công cộng theo khu vực |
| Hành vi phiên | Luân phiên mặc định hoặc địa chỉ IP tĩnh được gán | Yêu cầu độc lập hoặc hồ sơ lặp lại |
| Xác thực | Tên người dùng và mật khẩu proxy chuyên dụng | Trình duyệt, client proxy và máy thu thập dữ liệu máy chủ |
| Cấu trúc gói | Gói GB cố định hoặc số lượng IP thời hạn | Lưu lượng và thời gian dịch vụ có thể dự đoán |
Kế hoạch proxy Web Scraping
So sánh Kế hoạch Proxy Web Scraping
Chỉ sử dụng khi một nguồn được ủy quyền hoặc đường nghiên cứu lặp lại thực sự được lợi từ một địa chỉ mạng được gán trong một thời hạn định trước. Sử dụng cho việc thu thập trang công khai có giới hạn cần các yêu cầu độc lập theo quốc gia và được thiết kế dựa trên lưu lượng chuyển, xác thực và giới hạn thử lại nghiêm ngặt.
Proxy Dân cư Luân phiên
Proxy Dân cư Luân phiên thay đổi địa chỉ giữa các kết nối theo mặc định và sử dụng các gói GB cố định. Sử dụng cho việc thu thập trang công khai có giới hạn cần các yêu cầu độc lập theo quốc gia và được thiết kế dựa trên lưu lượng chuyển, xác thực và giới hạn thử lại nghiêm ngặt.
- Nhắm mục tiêu theo quốc gia từ các vị trí đã được xem xét
- Luân phiên ngẫu nhiên mặc định giữa các kết nối
- Xác thực bằng tên người dùng và mật khẩu chuyên dụng
Proxy ISP tĩnh
Proxy ISP tĩnh cung cấp địa chỉ được gán cho một quốc gia và thời hạn dịch vụ đã chọn. Chỉ sử dụng khi một nguồn được ủy quyền hoặc đường nghiên cứu lặp lại thực sự được lợi từ một địa chỉ mạng được gán trong một thời hạn định trước.
- Một địa chỉ được gán cho thời hạn đã chọn
- Nhận dạng mạng ổn định cho một hồ sơ được phê duyệt
- Chi tiết kết nối riêng cho mỗi tài nguyên
Cài đặt proxy Web Scraping
Cách thiết lập Proxy Web Scraping của bạn
Chọn sản phẩm và quốc gia, tạo chi tiết kết nối được hỗ trợ, sau đó xác thực một trang hoặc máy khách đã được phê duyệt trước khi mở rộng quy trình làm việc.
Tùy chỉnh các tham số proxy của bạn
Chọn Nhà cung cấp dịch vụ Internet luân phiên ở nhà hoặc tĩnh và chọn một quốc gia khả dụng cho quy trình thu thập dữ liệu web. Đối với ISP tĩnh, cũng chọn số lượng và điều khoản; Đối với Nhà ở, chọn gói lưu lượng cố định.
Tạo Chi Tiết Proxy Của Bạn
Mở không gian làm việc phù hợp và tạo hoặc hiển thị các chi tiết kết nối được hỗ trợ. Giữ thông tin đăng nhập proxy tách biệt với mật khẩu bảng điều khiển và mật khẩu tài khoản đích.
Cắm proxy vào ngăn xếp của bạn
Thêm kết nối vào hồ sơ trình duyệt, ứng dụng proxy hoặc bộ thu phía máy chủ đã được phê duyệt. Kiểm tra một trang hoặc quy trình làm việc Web Scraping, xác nhận quốc gia và phản hồi, sau đó mở rộng trong giới hạn đã viết.
Câu hỏi thường gặp về proxy Web Scraping
Câu hỏi thường gặp về proxy thu thập dữ liệu web
Chọn một địa chỉ được gán ổn định cho hồ sơ lặp lại và truy cập luân phiên nơi cư trú để thu thập dữ liệu công khai có giới hạn hoặc kiểm tra khu vực.
Proxy thu thập web là gì?
Một proxy thu thập web cung cấp một địa chỉ IP khác cho bộ thu trang công khai được phê duyệt. Đây là một tuyến mạng, không phải một bộ thu thập hoàn chỉnh: khách hàng vẫn sở hữu phạm vi nguồn, pacing, phân tích cú pháp, xác thực, lưu trữ và xóa.
Loại proxy IPMusk nào phù hợp với việc thu thập dữ liệu web?
Rotating Residential là sự phù hợp thông thường cho bộ sưu tập trang công khai có giới hạn trên các yêu cầu độc lập. ISP tĩnh chỉ áp dụng cho một đường dẫn lặp lại được ủy quyền cần một địa chỉ được gán. IPMusk không cung cấp proxy di động. Proxy Datacenter là một sản phẩm riêng dành cho các trang web chấp nhận lưu lượng từ datacenter: IP của nhà cung cấp hosting, không phải địa chỉ dân cư hay ISP.
Tôi có thể sử dụng proxy miễn phí để thu thập dữ liệu web không?
Proxy chia sẻ miễn phí thường không ổn định, tái sử dụng nhiều và khó kiểm toán. Truy cập xác thực với quốc gia, giới hạn lưu lượng hoặc thời hạn đã biết, chủ sở hữu khối lượng công việc, phạm vi trang và quy tắc dừng là một chuẩn mực rõ ràng hơn.
Proxy luân phiên giúp cạo như thế nào?
Chúng mặc định thay đổi địa chỉ giữa các kết nối và có thể tách riêng các yêu cầu độc lập. Chúng không thay thế cho việc điều chỉnh nhịp độ bảo thủ, lưu trữ bộ nhớ đệm, kiểm soát kích thước phản hồi, xác thực, thử lại có giới hạn, hoặc điều kiện dừng cho việc từ chối và thay đổi cấu trúc.
Liệu proxy thu thập dữ liệu web có vượt qua được CAPTCHA không?
Không có kết quả nào không có CAPTCHA được đảm bảo. Thách thức là phản hồi nguồn mà bộ thu cần phân loại và xử lý theo giao thức đã được phê duyệt, thường có giới hạn thử lại nghiêm ngặt hoặc dừng thay vì thay đổi địa chỉ lặp lại.
Proxy có thể được sử dụng để thu thập dữ liệu web công khai không?
Chúng có thể hỗ trợ việc thu thập các trường công khai được ủy quyền trong khuôn khổ quy tắc nguồn và phạm vi bằng văn bản. Họ không cho phép các khu vực riêng tư, vượt qua xác thực, vượt qua tường trả phí, thu thập dữ liệu cá nhân nhạy cảm hoặc phớt lờ các hạn chế kỹ thuật.
Nhiều giải pháp proxy hơn