Proxy de capture web
Proxies de capture web premium
Résidentiel tournant · FAI statique · Ciblage au niveau des pays · Authentification par accréditation
- Tracez les collecteurs de pages publiques approuvés via des adresses proxy distinctes
- Faites pivoter les adresses entre les URL, les pages et les schémas de rafraîchissement
- Collecter des données publiques localisées avec un ciblage au niveau des pays
- Utilisez une adresse assignée lorsqu’une référence source répétée nécessite une continuité
Pourquoi les proxys de Web Scraping
Qu’est-ce qu’un proxy pour le web scraping ?
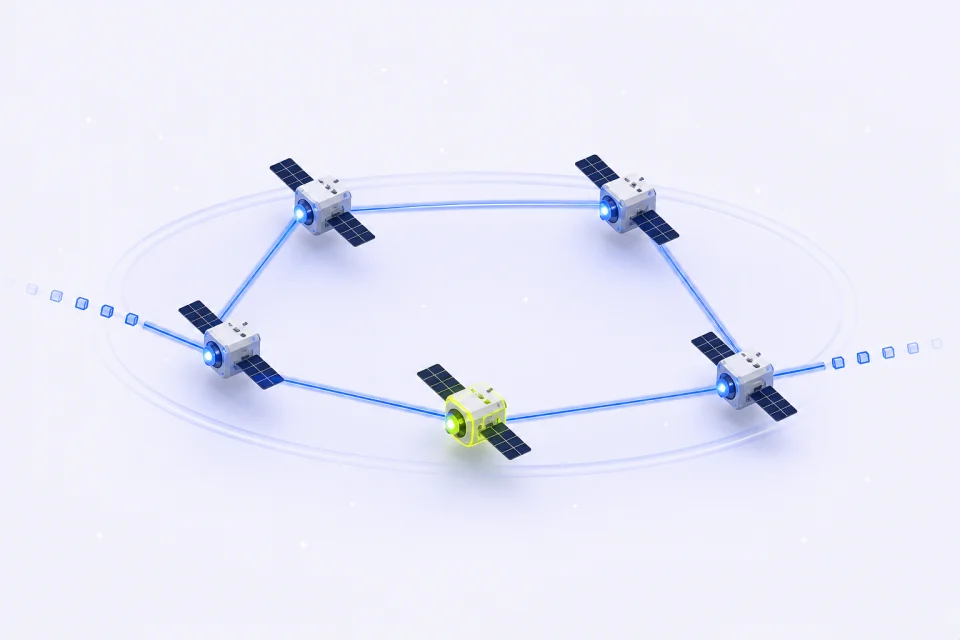
Un proxy pour le web scraping agit comme intermédiaire entre un collectionneur agréé et un site web public. Il fournit une autre adresse IP à la requête au lieu d’utiliser l’adresse réseau habituelle de l’opérateur.
Une équipe de données web peut utiliser le routage proxy pour les pages publiques de produits, recherches, catégories, annuaires, articles ou autres pages approuvées lorsque les champs, URL, pays, cadence de rafraîchissement et conditions d’arrêt requis sont définis en premier.
L’accès résidentiel rotatif correspond à une collection délimitée nécessitant des demandes indépendantes à travers les pays disponibles. Un FAI statique correspond à une source autorisée qui bénéficie réellement d’une adresse assignée au fil de sessions répétées.
Par exemple, un collecteur de prix peut demander une liste d’articles canonique via des itinéraires résidentiels tournants, valider chaque réponse et champ extrait, mettre en cache les pages non modifiées, arrêter les refus répétés et mettre en quarantaine des modèles inattendus pour examen.
Cas d’utilisation de proxy de Web Scraping
Comment fonctionnent les proxys de capture web
Utilisez le routage proxy comme une couche contrôlée dans un système de données publiques approuvé avec une portée explicite, un rythme, une validation, des budgets de trafic et des conditions d’arrêt explicites.
Protégez l’identité de votre grattoir
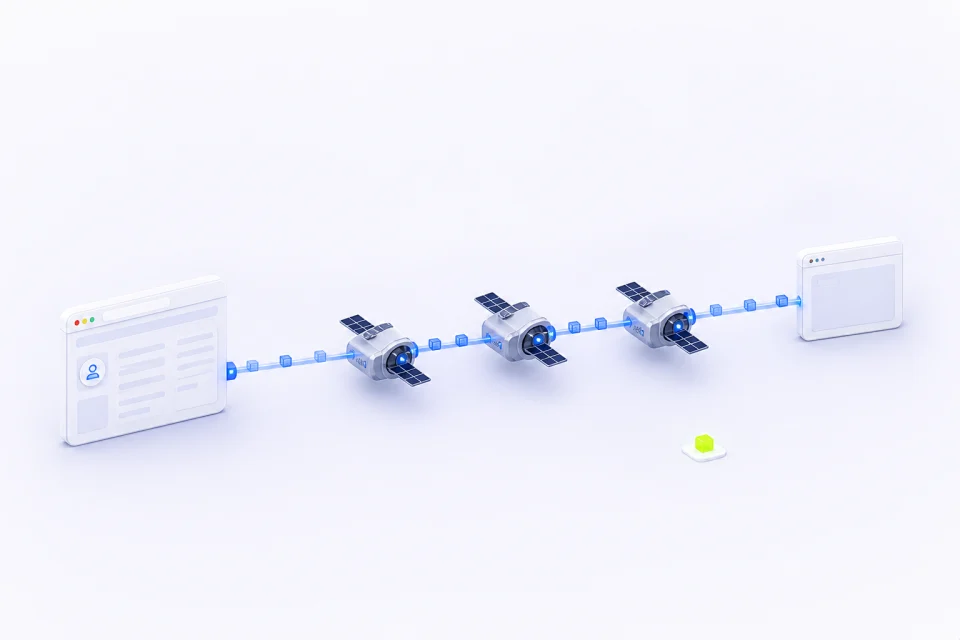
Un proxy garde l’adresse réseau normale du collecteur hors du chemin de requête approuvé pour la page publique et fournit une authentification proxy dédiée.
Ajustement IPMusk : garder les identifiants proxy, les données du compte source et le contenu sensible des pages hors des journaux et captures d’écran.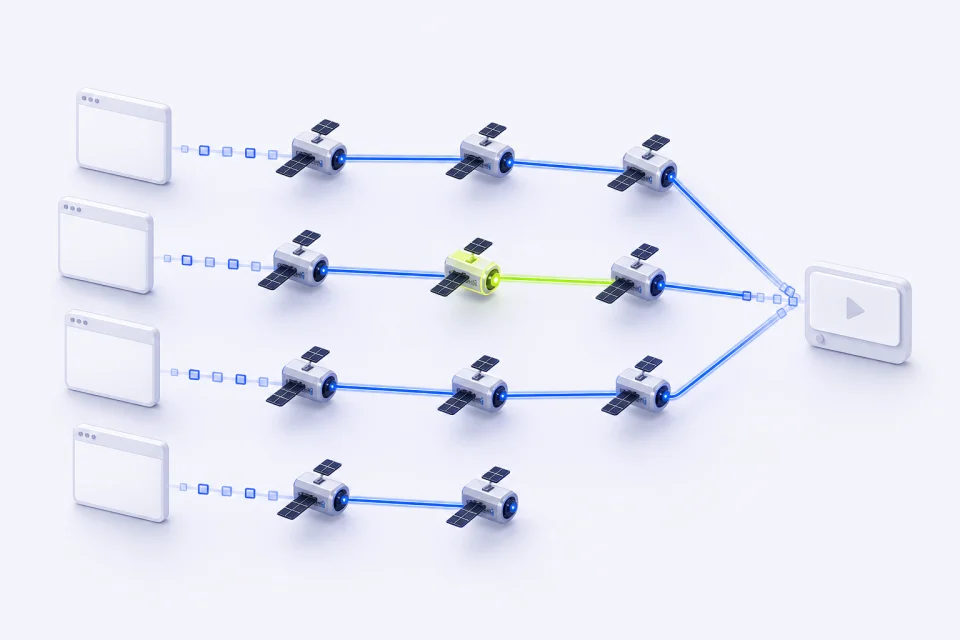
Faire pivoter les IP entre les requêtes indépendantes
La rotation par défaut sépare les requêtes URL et de pagination indépendantes dans un travail de collection bornée au lieu d’envoyer chaque requête via une seule adresse.
Adéquation IPMusk : définir une concurrence conservatrice, un rythme, des temps morts, des plafonds de réessaie et un arrêt immédiat.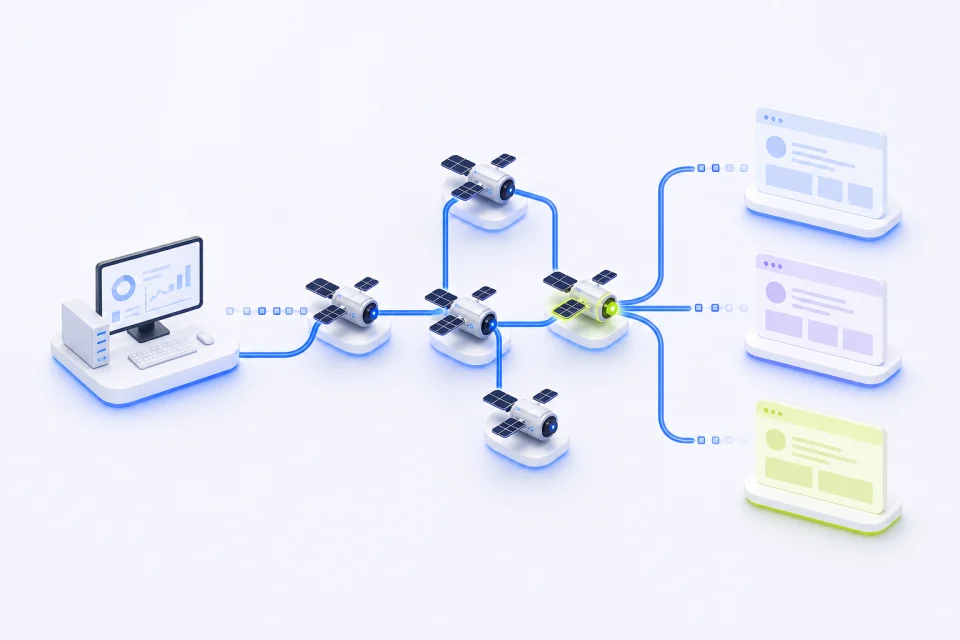
Ciblez des pays spécifiques pour des données localisées
Les itinéraires au niveau des pays permettent de comparer les prix publics approuvés, les catalogues, les pages de recherche, les avis et le contenu régional lorsque d’autres entrées du navigateur restent contrôlées.
IPMusk : sélection par pays et par État ; le ciblage de ville, d'ASN ou d'opérateur n'est pas proposé.
Maintenir la qualité des données mesurée
Le statut de la réponse seul ne suffit pas : validez les champs requis, les modèles de page, l’état du pays, les doublons, la version du parseur et les horodatages de la source avant d’accepter un enregistrement.
Ajustement IPMusk : mesure les enregistrements utiles par unité de trafic, pas le volume brut de requêtes ni le nombre de réponses.Fonctionnalités du proxy d’extraction Web IPMusk
Comment les proxies de web scraping d’IPMusk se distinguent
Deux produits clairement séparés couvrent des requêtes de recherche rotatives et des flux de travail stables à adresses attribuées sans mélanger leur comportement de session ou leur modèle de facturation.
| Caractéristiques | IPMusk | Meilleur ajustement |
|---|---|---|
| Options de proxy | Résidentiel rotatif ISP statique | Données publiques et environnements assignés stables |
| Contrôle de localisation | Sélection par pays | Comparaisons de pages publiques régionales |
| Comportement de session | Rotation par défaut ou IP statique assignée | Requêtes indépendantes ou profils répétés |
| Authentification | Nom d'utilisateur et mot de passe proxy dédiés | Navigateurs, clients proxy et collecteurs de serveur |
| Structure du plan | Forfaits GB fixes ou quantité d'IP durée | Trafic prévisible et durée de service |
Plans de proxy pour le web scraping
Comparer les plans de proxy pour le web scraping
Utilisez-le uniquement lorsqu'une source autorisée ou un chemin de recherche répété bénéficie réellement d'une adresse réseau assignée sur une période définie. Utilisez-le pour la collecte de pages publiques limitée qui nécessite des requêtes indépendantes au niveau du pays et est conçue autour du trafic transféré, de la validation et de limites strictes de nouvelle tentative.
Proxies résidentiels rotatifs
Les proxies résidentiels rotatifs changent d’adresses entre les connexions par défaut et utilisent des forfaits GB fixes. Utilisez-le pour la collecte de pages publiques limitée qui nécessite des requêtes indépendantes au niveau du pays et est conçue autour du trafic transféré, de la validation et de limites strictes de nouvelle tentative.
- Ciblage au niveau du pays à partir de lieux examinés
- Rotation aléatoire par défaut entre les connexions
- Authentification dédiée par nom d'utilisateur et mot de passe
Proxies ISP statiques
Les proxies ISP statiques fournissent des adresses assignées pour un pays sélectionné et une durée de service. Utilisez-le uniquement lorsqu'une source autorisée ou un chemin de recherche répété bénéficie réellement d'une adresse réseau assignée sur une période définie.
- Une adresse assignée pour la durée sélectionnée
- Identité réseau stable pour un profil approuvé
- Détails de connexion individuels pour chaque ressource
Configuration d’un proxy pour le web scraping
Comment configurer vos proxies pour le web scraping
Choisissez le produit et le pays, générez les détails de connexion pris en charge, puis validez une page ou un client approuvé avant d’étendre le flux de travail.
Personnalisez vos paramètres de proxy
Choisissez Fournisseur d’accès à Internet résidentiel ou statique et sélectionnez un pays disponible pour le flux de travail de Web Scraping. Pour le FAI statique, choisissez également la quantité et le terme ; pour le résidentiel, choisissez le forfait trafic fixe.
Générez vos informations de procuration
Ouvrez l’espace de travail correspondant et générez ou révélez les détails de connexion pris en charge. Gardez les identifiants proxy séparés des mots de bord et des comptes de destination.
Branchez le proxy dans votre pile
Ajoutez la connexion au profil navigateur approuvé, au client proxy ou au collecteur côté serveur. Testez une page ou un flux de travail de Web Scraping, confirmez le pays et la réponse, puis faites évoluer dans les limites écrites.
FAQ sur les proxy de capture web
FAQ sur les proxys de web scraping
Choisissez une adresse stable attribuée pour les profils répétés et un accès résidentiel rotatif pour la collecte de données publiques bornées ou les vérifications régionales.
Qu’est-ce qu’un proxy de web scraping ?
Un proxy de web scraping fournit une autre adresse IP à un collecteur de pages publiques approuvé. C’est une route réseau, pas un scraper complet : le client possède toujours la portée source, le rythme, l’analyse syntatique, la validation, le stockage et la suppression.
Quel type de proxy IPMusk convient au web scraping ?
Le mode résidentiel rotatif est la solution normale pour la collecte délimitée de pages publiques entre les demandes indépendantes. Le FAI statique est uniquement pour un chemin de répétition autorisé nécessitant une adresse assignée. IPMusk ne propose pas de proxys mobiles. Les proxys Datacenter sont un produit distinct, destiné aux sites qui acceptent le trafic de datacenter : des IP d'hébergeurs, et non des adresses résidentielles ou ISP.
Puis-je utiliser des proxies gratuits pour le web scraping ?
Les proxys partagés libres sont souvent instables, fortement réutilisés et difficiles à auditer. L’accès authentifié avec des limites de pays connus, de trafic ou de durée, le propriétaire de la charge de travail, la portée de la page et les règles d’arrêt est une base de référence plus claire.
Comment les proxies rotatifs aident-ils à réduire le scraping ?
Ils changent d’adresses entre les connexions par défaut et peuvent séparer les requêtes indépendantes. Ils ne remplacent pas le rythme conservateur, la mise en cache, les contrôles de taille de la réponse, la validation, les tentatives bornées, ni une condition d’arrêt pour le refus et les changements structurels.
Les proxies de web scraping contournent-ils les CAPTCHA ?
Aucun résultat sans CAPTCHA n’est garanti. Un défi est une réponse source que le collecteur doit classifier et gérer selon son protocole approuvé, généralement avec un plafond ou un arrêt strict de la réessayage plutôt que des changements répétés d’adresse.
Les proxys peuvent-ils être utilisés pour la collecte de données publiques sur le web ?
Ils peuvent supporter la collecte autorisée de champs publics au sein des règles sources et d’un champ écrit. Ils n’autorisent pas les zones privées, le contournement de l’authentification, la contournement du paywall, la collecte de données personnelles sensibles ni l’ignorance de restrictions techniques.
Plus de solutions proxy