Proxy per web scraping
Proxy Premium per Web Scraping
Residenziale Rotativo · ISP Statico · Targeting a livello di paese · Autenticazione con credenziali
- Instrada i raccoglitori di pagine pubbliche approvate attraverso indirizzi proxy separati
- Ruota gli indirizzi tra URL limitati, pagine e programmi di aggiornamento
- Raccogli dati pubblici localizzati con targeting a livello di paese
- Usa un indirizzo assegnato quando una fonte ripetuta ha bisogno di continuità nella baseline
Perché i proxy per Web Scraping
Che cos'è un Proxy per il Web Scraping?
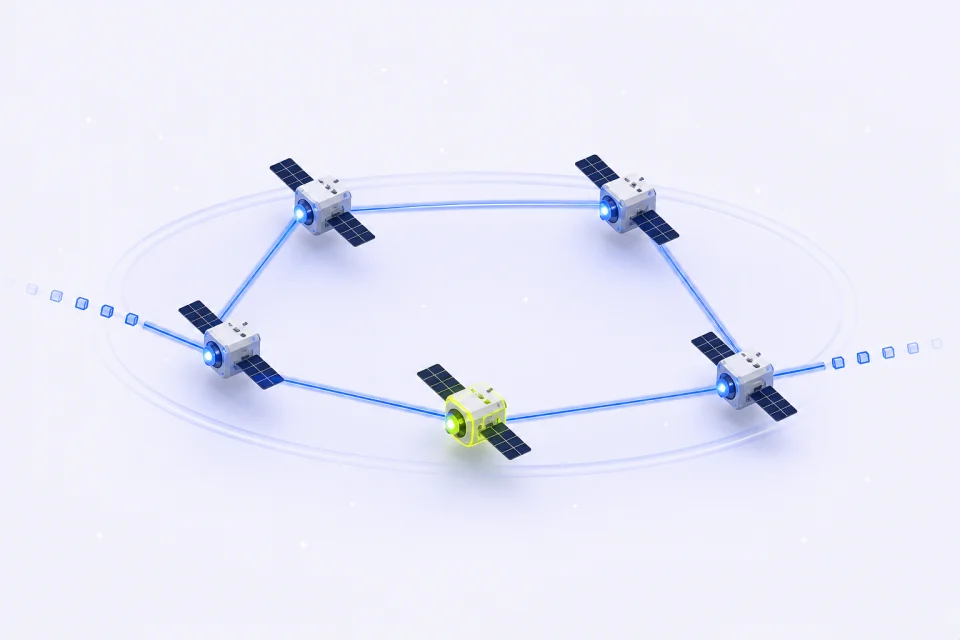
Un proxy per il web scraping agisce come intermediario tra un raccoglitore approvato e un sito web pubblico. Fornisce un altro indirizzo IP alla richiesta invece di usare l'indirizzo di rete abituale dell'operatore.
Un team di dati web può usare il routing tramite proxy per pagine pubbliche di prodotto, ricerca, categoria, directory, articoli o altre pagine approvate quando i campi richiesti, gli URL, i paesi, la cadenza di aggiornamento e le condizioni di stop sono definiti prima.
L'accesso residenziale rotativo è adatto a raccolte limitate che necessitano di richieste indipendenti tra i paesi disponibili. L'ISP Statico è adatto a una fonte autorizzata che trae genuinamente beneficio da un indirizzo assegnato durante sessioni ripetute.
Ad esempio, un esattore di prezzi può richiedere una lista canonica di oggetti attraverso rotte residenziali rotanti, validare ogni risposta e campo estratto, memorizzare in cache le pagine non modificate, interrompere ripetuti rifiuti e mettere in quarantena modelli imprevisti per la revisione.
Casi d'uso proxy per Web Scraping
Come funzionano i proxy per il web scraping
Utilizzare il routing proxy come un unico livello controllato in un sistema di dati pubblici approvato con ambito, ritmo, validazione, budget di traffico e condizioni di stop espliciti.
Proteggi l'identità del tuo raschiatore
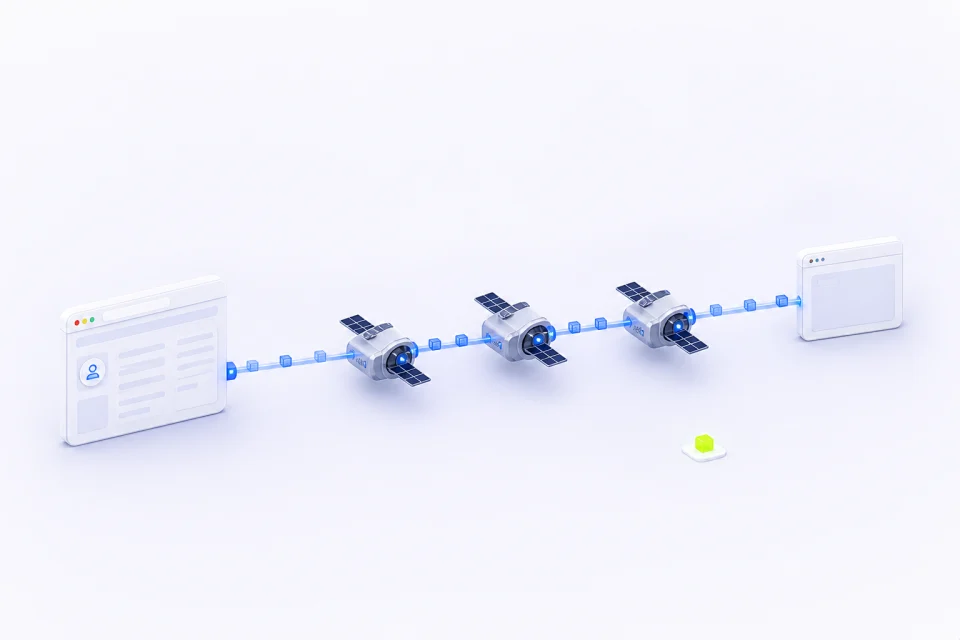
Un proxy mantiene l'indirizzo di rete normale del collector fuori dal percorso di richiesta approvato per la pagina pubblica e fornisce un'autenticazione proxy dedicata.
Adattamento IPMusk: tieni fuori dalle credenziali proxy, dai dati dell'account sorgente e dai contenuti sensibili delle pagine dai log e dagli screenshot.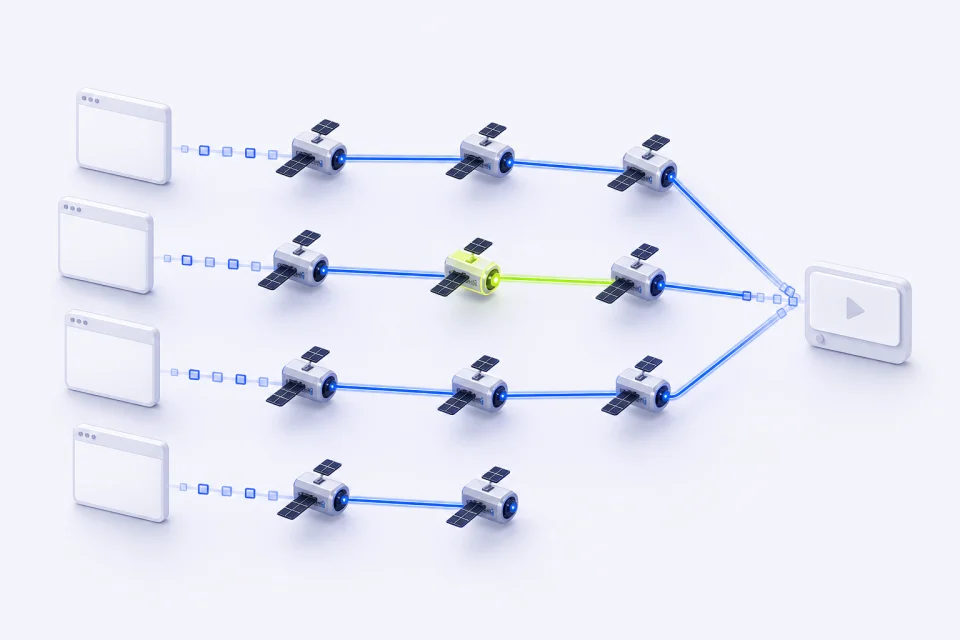
Ruota gli IP tra richieste indipendenti
La rotazione predefinita separa le richieste indipendenti di URL e paginazione in un lavoro di raccolta limitata invece di inviare ogni richiesta attraverso un unico indirizzo.
IPMusk adattamento: imposta una concorrenza conservativa, ritmo, timeout, limiti di ritentazione e un percorso di stop immediato.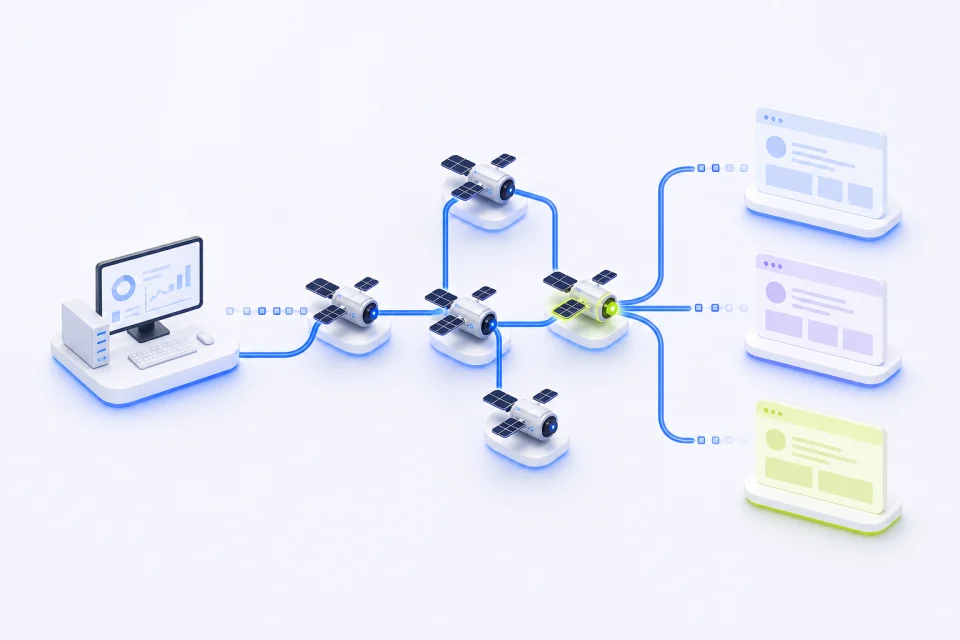
Obiettivi di paesi specifici per dati localizzati
Le rotte a livello di paese aiutano a confrontare prezzi pubblici approvati, cataloghi, pagine di ricerca, avvisi e contenuti regionali quando altri input del browser rimangono controllati.
Compatibilità IPMusk: selezione di paese e stato; non è offerto il targeting per città, ASN o operatore.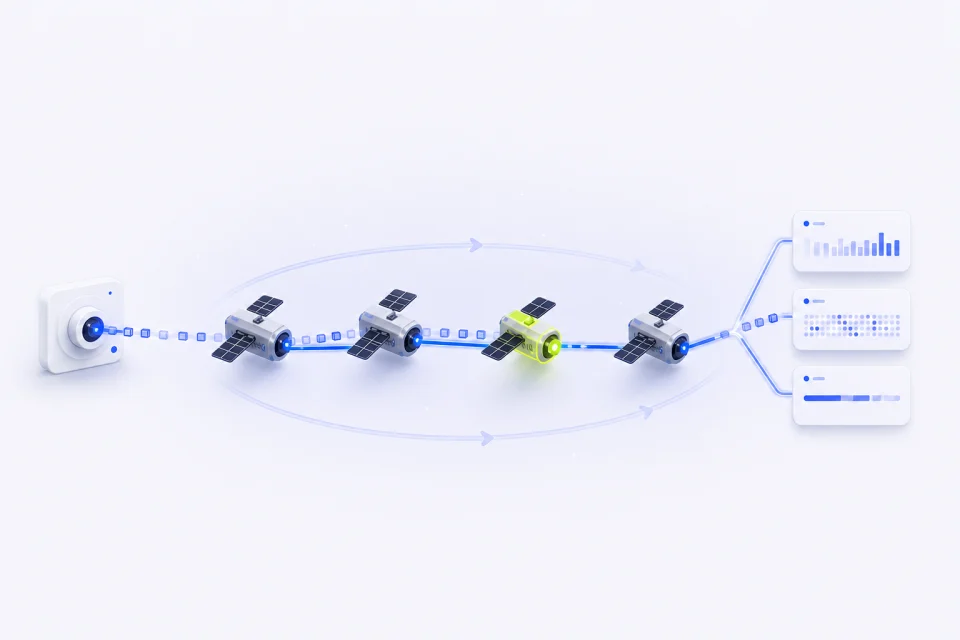
Mantenere la qualità dei dati misurata
Lo stato della risposta da solo non è sufficiente: valida i campi richiesti, i template di pagina, lo stato del paese, i duplicati, la versione del parser e i timestamp della sorgente prima di accettare un record.
IPMusk fit: misura i record utili per unità di traffico, non il volume grezzo delle richieste o il numero di risposte.Funzionalità del proxy di IPMusk Web Scraping
Come si distinguono i proxy per il web scraping di IPMusk
Due prodotti chiaramente separati coprono richieste di ricerca rotanti e flussi di lavoro stabili con indirizzi assegnati senza mescolare il comportamento delle sessioni o il modello di fatturazione.
| Caratteristiche | IPMusk | La migliore scelta |
|---|---|---|
| Opzioni proxy | ISP statico residenziale rotante | Dati pubblici e ambienti assegnati stabili |
| Controllo della posizione | Selezione a livello nazionale | Confronti regionali tra pagine pubbliche e pagine pubbliche |
| Comportamento della sessione | Rotazione predefinita o IP statico assegnato | Richieste indipendenti o profili ripetuti |
| Autenticazione | Nome utente e password proxy dedicati | Browser, client proxy e collezionisti server |
| Struttura del piano | Pacchetti GB fissi o termini di quantità IP | Traffico prevedibile e durata del servizio |
Piani proxy per il Web Scraping
Confronta i piani proxy per web scraping
Usalo solo quando una fonte autorizzata o un percorso di ricerca ripetuto beneficia davvero di un indirizzo di rete assegnato in un periodo definito. Utilizzalo per la raccolta limitata di pagine pubbliche che richiedono richieste indipendenti a livello di paese ed è progettato attorno al traffico trasferito, alla validazione e a limiti rigorosi di ritento.
Proxy residenziali rotanti
I Proxy Residenziali rotanti cambiano gli indirizzi tra le connessioni di default e utilizzano pacchetti GB fissi. Utilizzalo per la raccolta limitata di pagine pubbliche che richiedono richieste indipendenti a livello di paese ed è progettato attorno al traffico trasferito, alla validazione e a limiti rigorosi di ritento.
- Targeting a livello di paese dalle località revisionate
- Rotazione casuale predefinita tra le connessioni
- Autenticazione dedicata a nome utente e password
Proxy ISP statici
I proxy ISP statici forniscono indirizzi assegnati per un paese e un termine di servizio selezionati. Usalo solo quando una fonte autorizzata o un percorso di ricerca ripetuto beneficia davvero di un indirizzo di rete assegnato in un periodo definito.
- Un indirizzo assegnato per il periodo selezionato
- Identità stabile di rete per un profilo approvato
- Dettagli individuali delle connessioni per ogni risorsa
Configurazione del proxy per Web Scraping
Come configurare i tuoi proxy per il web scraping
Scegli il prodotto e il paese, genera i dettagli di connessione supportati, poi valida una pagina o un cliente approvato prima di espandere il flusso di lavoro.
Personalizza i parametri del tuo proxy
Scegli ISP residenziale rotante o statico e seleziona un paese disponibile per il flusso di lavoro del Web Scraping. Per ISP statico, si sceglie anche quantità e termine; per il Residenziale, scegli il pacchetto traffico fisso.
Genera i dati del tuo proxy
Apri lo spazio di lavoro corrispondente e genera o rivela i dettagli della connessione supportati. Tieni separate le credenziali proxy dal dashboard e dalle password dell'account di destinazione.
Collega il proxy al tuo stack
Aggiungi la connessione al profilo browser approvato, al client proxy o al collector lato server. Testa una pagina o un flusso di lavoro Web Scraping, conferma il paese e la risposta, poi scala entro i limiti scritti.
FAQ sui proxy per il web scraping
FAQ sui proxy per il web scraping
Scegli un indirizzo stabile assegnato per profili ripetuti e per l'accesso residenziale rotativo per la raccolta dati pubblici limitata o controlli regionali.
Cos'è un proxy per il web scraping?
Un proxy di web scraping fornisce un altro indirizzo IP a un raccoglitore di pagine pubbliche approvato. Si tratta di una rotta di rete, non di uno scraper completo: il client possiede ancora l'ambito della sorgente, il ritmo, l'analisi sintica, la validazione, l'archiviazione e la cancellazione.
Quale tipo di proxy IPMusk si adatta al web scraping?
Rotating Residential è l'opzione normale per la raccolta di pagine pubbliche limitate attraverso richieste indipendenti. Static ISP è solo per un percorso ripetuto autorizzato che necessita di un indirizzo assegnato. IPMusk non offre proxy mobili. I proxy Datacenter sono un prodotto separato per i siti che accettano traffico da datacenter: IP di fornitori di hosting, non indirizzi residenziali o ISP.
Posso usare proxy gratuiti per il web scraping?
I proxy gratuiti condivisi sono spesso instabili, molto riutilizzati e difficili da controllare. L'accesso autenticato con paese noto, limiti di traffico o termini, proprietario del carico di lavoro, ambito della pagina e regole di stop è una base più chiara.
Come aiutano i proxy rotanti con il scraping?
Cambiano gli indirizzi tra le connessioni di default e possono separare richieste indipendenti. Non sostituiscono la gestione conservativa della velocità, caching, controlli della dimensione della risposta, validazione, tentativi limitati o una condizione di stop per negazioni e cambiamenti strutturali.
I proxy per web scraping bypassano i CAPTCHA?
Nessun risultato senza CAPTCHA è garantito. Una sfida è una risposta della fonte che il collettore dovrebbe classificare e gestire secondo il protocollo approvato, solitamente con un limite rigoroso di tentativi o uno stop piuttosto che cambiamenti ripetuti di indirizzo.
I proxy possono essere utilizzati per la raccolta di dati web pubblici?
Possono supportare la raccolta autorizzata di campi pubblici entro le regole della fonte e un ambito scritto. Non autorizzano aree private, bypass dell'autenticazione, elusione del paywall, raccolta di dati personali sensibili o ignorare restrizioni tecniche.
Altre soluzioni proxy