Proxy de web scraping
Proxies Premium de Web Scraping
Residencial rotativo · ISP estático · Targeting a nivel de país · Autenticación de credenciales
- Enruta los recolectores de páginas públicas aprobadas a través de direcciones proxy separadas
- Rota las direcciones en URLs, páginas y horarios de actualización delimitados
- Recoge datos públicos localizados con targeting a nivel de país
- Usa una dirección asignada cuando una fuente de repetición necesite continuidad
Por qué proxies de Web Scraping
¿Qué es un Proxy para Web Scraping?
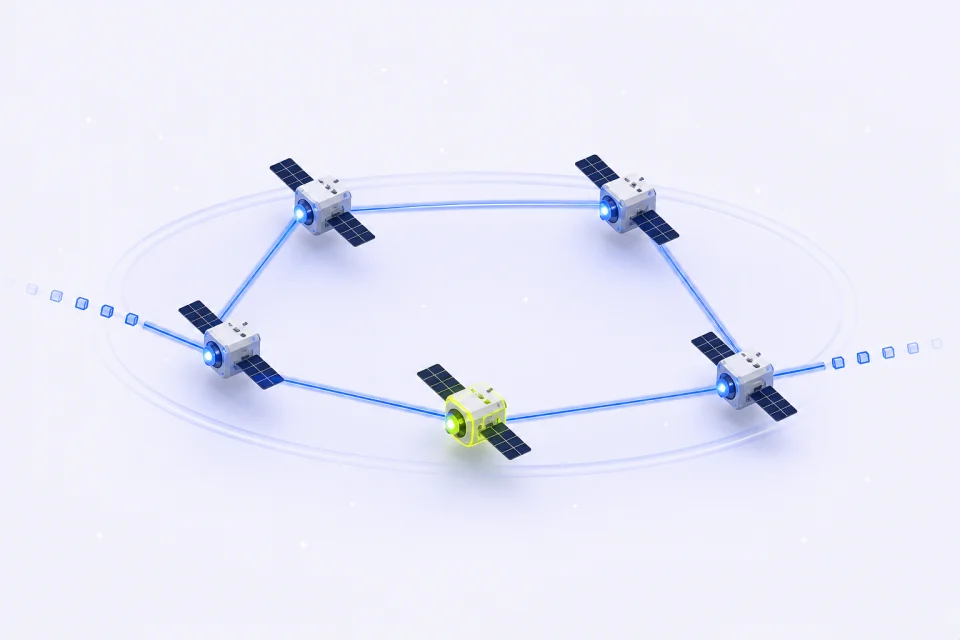
Un proxy para web scraping actúa como intermediario entre un recolector aprobado y un sitio web público. Suministra otra dirección IP a la solicitud en lugar de usar la dirección de red habitual del operador.
Un equipo de datos web puede usar el enrutamiento a través de proxy para páginas de productos, búsqueda, categoría, directorio, artículo u otras páginas aprobadas cuando los campos requeridos, URLs, países, cadencia de actualización y condiciones de detención se definan primero.
El acceso residencial rotativo se ajusta a la colección limitada que necesita solicitudes independientes en los países disponibles. El ISP estático se ajusta a una fuente autorizada que realmente se beneficia de una dirección asignada en sesiones repetidas.
Por ejemplo, un recolector de precios puede solicitar una lista canónica de artículos a través de rutas residenciales rotativas, validar cada respuesta y campo extraído, almacenar en caché las páginas sin cambios, detenerse ante denegaciones repetidas y aislar plantillas inesperadas para su revisión.
Casos de uso de proxies para Web Scraping
Cómo Funcionan los Proxies para Web Scraping
Utilice el enrutamiento por proxy como una capa controlada en un sistema de datos públicos aprobado con alcance explícito, ritmo, validación, presupuestos de tráfico y condiciones de detención.
Proteja la Identidad de su Raspador
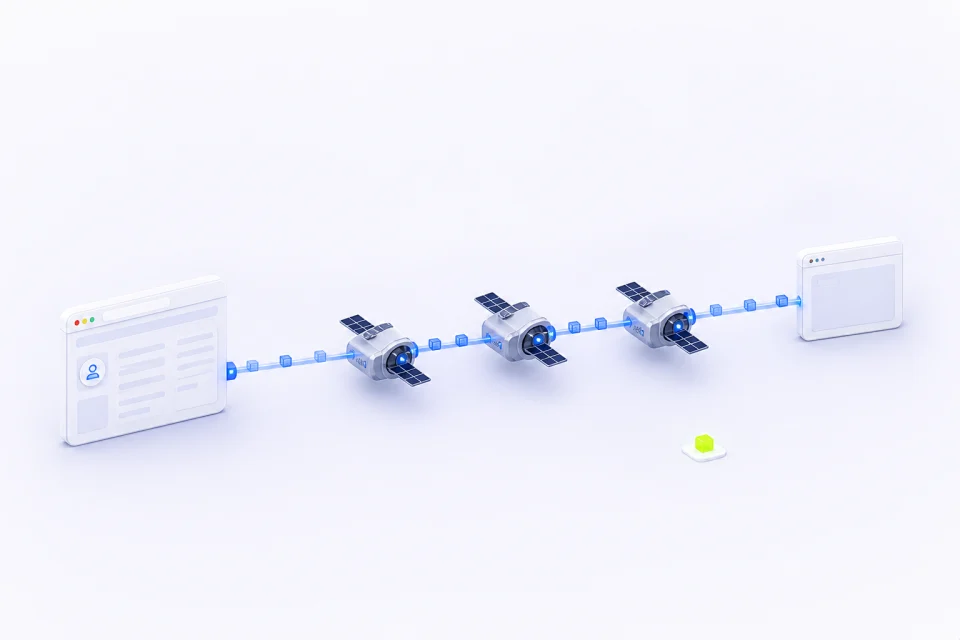
Un proxy mantiene la dirección de red normal del recolector fuera del camino de solicitud de páginas públicas aprobadas y proporciona autenticación de proxy dedicada.
Configuración de IPMusk: mantenga las credenciales del proxy, los datos de la cuenta de origen y el contenido sensible de las páginas fuera de los registros y capturas de pantalla.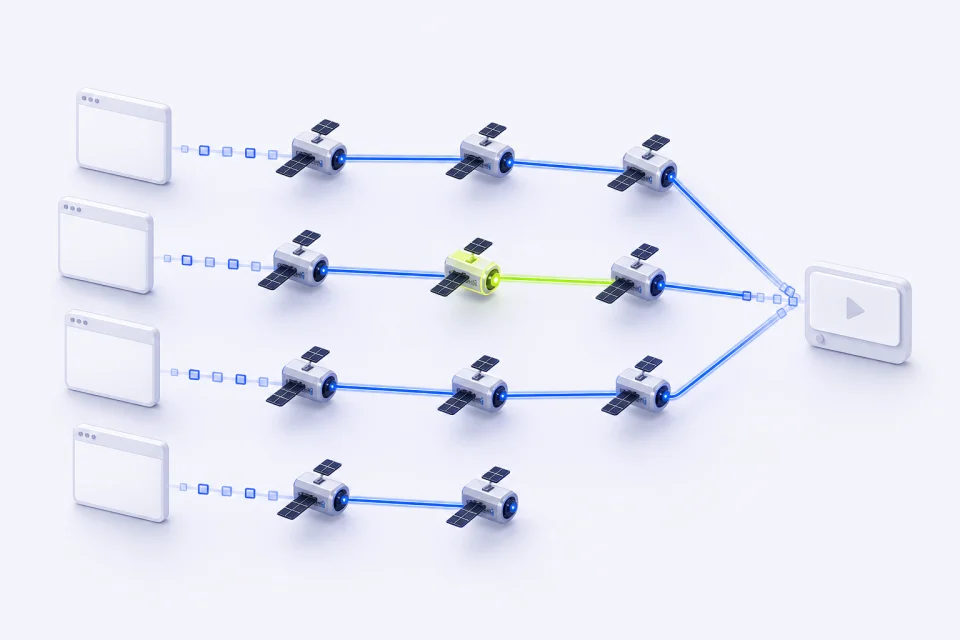
Rote IPs Entre Solicitudes Independientes
La rotación predeterminada separa las solicitudes de URL y paginación independientes en un trabajo de colección limitado en lugar de enviar cada solicitud a través de una sola dirección.
Configuración de IPMusk: establezca concurrencia conservadora, ritmo, tiempos de espera, límites de reintento y una ruta de parada inmediata.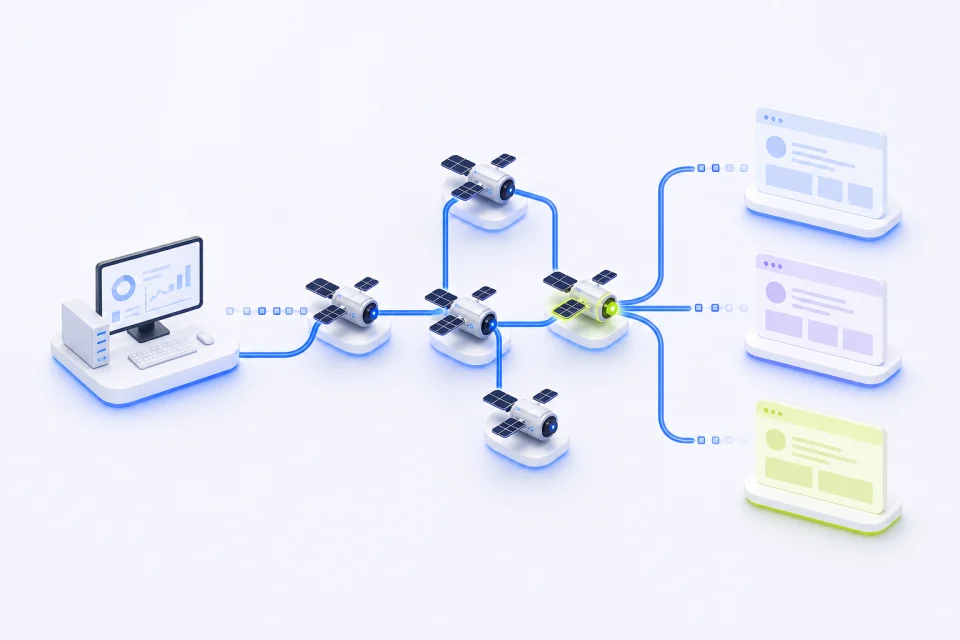
Apunte a Países Específicos para Datos Localizados
Las rutas a nivel de país ayudan a comparar precios públicos aprobados, catálogos, páginas de búsqueda, avisos y contenido regional cuando otros inputs del navegador permanecen controlados.
Configuración de IPMusk: selección de país y estado; no se ofrece segmentación por ciudad, ASN u operador.
Mantenga la Calidad de Datos Medida
Solo el estado de la respuesta no es suficiente: valide campos requeridos, plantillas de página, estado del país, duplicados, versión del analizador y marcas de tiempo de origen antes de aceptar un registro.
Configuración de IPMusk: mida registros útiles por unidad de tráfico, no el volumen bruto de solicitudes o el conteo de respuestas.Características de los proxies para Web Scraping de IPMusk
Cómo se Destacan los Proxies para Web Scraping de IPMusk
Dos productos claramente separados cubren solicitudes de investigación rotativas y flujos de trabajo con direcciones asignadas estables sin mezclar su comportamiento de sesión o modelo de facturación.
| Característica | IPMusk | Mejor opción |
|---|---|---|
| Opciones de proxy | ISP residencial rotatorio estático | Datos públicos y entornos estables asignados |
| Control de ubicación | Selección a nivel nacional | Comparaciones regionales de páginas públicas |
| Comportamiento en sesión | Rotación predeterminada o IP estática asignada | Solicitudes independientes o perfiles repetidos |
| Autenticación | Nombre de usuario y contraseña proxy dedicados | Navegadores, clientes proxy y coleccionistas de servidores |
| Estructura del plan | Paquetes GB fijos o término de cantidad IP | Tráfico predecible y duración del servicio |
Planes proxy de Web Scraping
Compara los planes de proxy de extracción web
Úsalo solo cuando una fuente autorizada o una ruta de investigación repetida se beneficie realmente de una dirección de red asignada durante un periodo definido. Úsalo para la recopilación acotada de páginas públicas que requieren solicitudes independientes a nivel de país y están diseñadas en torno al tráfico transferido, la validación y límites estrictos de reintentos.
Proxies Residenciales Rotativos
Los Proxies Residenciales rotativos cambian las direcciones entre conexiones por defecto y usan paquetes GB fijos. Úsalo para la recopilación acotada de páginas públicas que requieren solicitudes independientes a nivel de país y están diseñadas en torno al tráfico transferido, la validación y límites estrictos de reintentos.
- Segmentación a nivel de país desde ubicaciones revisadas
- Rotación aleatoria predeterminada entre conexiones
- Autenticación dedicada de nombres de usuario y contraseña
Proxies estáticos de ISP
Los proxies estáticos de ISP proporcionan direcciones asignadas para un país y término de servicio seleccionados. Úsalo solo cuando una fuente autorizada o una ruta de investigación repetida se beneficie realmente de una dirección de red asignada durante un periodo definido.
- Una dirección asignada para el periodo seleccionado
- Identidad estable de red para un perfil aprobado
- Detalles individuales de la conexión para cada recurso
Configuración de proxy de Web Scraping
Cómo configurar tus proxies de extracción web
Elige el producto y el país, genera los detalles de la conexión soportados y luego valida una página o cliente aprobado antes de ampliar el flujo de trabajo.
Personaliza los parámetros de tu proxy
Elige ISP residencial rotativo o estático y selecciona un país disponible para el flujo de trabajo de Web Scraping. Para ISP estático, también elige cantidad y término; para residencial, elige el paquete de tráfico fijo.
Genera los datos de tu proxy
Abre el espacio de trabajo correspondiente y genera o revela los detalles de la conexión compatibles. Mantén las credenciales proxy separadas del panel de control y de las contraseñas de la cuenta de destino.
Conecta el proxy a tu pila
Añade la conexión al perfil aprobado del navegador, al cliente proxy o al colector del lado del servidor. Prueba una página o flujo de trabajo de Web Scraping, confirma el país y la respuesta, y luego escala dentro de los límites escritos.
Preguntas frecuentes sobre proxies para web scraping
Preguntas frecuentes sobre proxies de web scraping
Elige una dirección estable asignada para perfiles repetidos y acceso residencial rotativo para recogida de datos públicos acotados o comprobaciones regionales.
¿Qué es un proxy de web scraping?
Un proxy de web scraping proporciona otra dirección IP a un recolector de páginas públicas aprobado. Es una ruta de red, no un scraper completo: el cliente sigue siendo propietario del alcance de la fuente, el ritmo, el análisis sintáctico, la validación, el almacenamiento y la eliminación.
¿Qué tipo de proxy IPMusk se adapta al web scraping?
Rotating Residential es el ajuste normal para la recopilación de páginas públicas limitadas a través de solicitudes independientes. El ISP estático es solo para un camino repetido autorizado que necesita una dirección asignada. IPMusk no ofrece proxies móviles. Los proxies de centro de datos son un producto aparte para sitios que aceptan tráfico de centro de datos: IP de proveedores de alojamiento, no direcciones residenciales ni de ISP.
¿Puedo usar proxies gratuitos para web scraping?
Los proxies compartidos gratuitos a menudo son inestables, se reutilizan mucho y son difíciles de auditar. El acceso autenticado con país conocido, tráfico o límites de términos, propietario de la carga de trabajo, alcance de la página y reglas de parada es una línea base más clara.
¿Cómo ayudan los proxies rotativos con el scraping?
Cambian las direcciones entre conexiones por defecto y pueden separar solicitudes independientes. No reemplazan la velocidad conservadora, la caché, los controles de tamaño de respuesta, la validación, los reintentos limitados o una condición de parada por denegación y cambios estructurales.
¿Los proxies de web scraping omiten los CAPTCHAs?
No se garantiza un resultado libre de CAPTCHA. Un desafío es una respuesta de origen que el colector debe clasificar y manejar de acuerdo con su protocolo aprobado, usualmente con un límite estricto de reintentos o parada en lugar de cambios de dirección repetidos.
¿Se pueden usar proxies para la recopilación de datos web públicos?
Pueden soportar la recopilación autorizada de campos públicos dentro de las reglas de origen y un alcance escrito. No autorizan áreas privadas, eludir la autenticación, la circunvalación de paywalls, la recopilación de datos personales sensibles ni ignorar restricciones técnicas.
Más soluciones de proxies