Web-Scraping-Proxy
Premium-Webscraping-Proxys
Rotating Residential · Static ISP · Zielsetzung auf Länderebene · Authentifizierung der Zugangsdaten
- Routen genehmigter öffentlicher Seiten-Sammler über separate Proxy-Adressen
- Drehen Sie Adressen über begrenzte URLs, Seiten und Aktualisierungspläne
- Sammeln Sie lokalisierte öffentliche Daten mit landesspezifischer Zielsetzung
- Verwenden Sie eine zugewiesene Adresse, wenn eine Repeat-Source-Baseline Kontinuität benötigt
Warum Webscraping-Proxys
Was ist ein Proxy für Web Scraping?
Ein Proxy für Web Scraping fungiert als Vermittler zwischen einem genehmigten Sammler und einer öffentlichen Website. Es stellt der Anfrage eine weitere IP-Adresse zur Verfügung, anstatt die übliche Netzwerkadresse des Betreibers zu verwenden.
Ein Web-Datenteam kann Proxy-Routing für öffentliche Produkt-, Such-, Kategorien-, Verzeichnis-, Artikel- oder andere genehmigte Seiten verwenden, wenn zuerst die erforderlichen Felder, URLs, Länder, Aktualisierungsrhythmus und Stoppbedingungen definiert sind.
Der rotierende Wohnzugang passt zu einer begrenzten Sammlung, die unabhängige Anfragen über verfügbare Länder hinweg benötigt. Der statische ISP passt zu einer autorisierten Quelle, die tatsächlich von einer zugewiesenen Adresse über wiederholte Sitzungen profitiert.
Zum Beispiel kann ein Preissammler eine kanonische Artikelliste über rotierende Wohnrouten anfordern, jede Antwort und jedes extrahierte Feld validieren, unveränderte Seiten cachen, bei wiederholter Ablehnung stoppen und unerwartete Vorlagen zur Überprüfung in Quarantäne stellen.
Anwendungsfälle von Webscraping-Proxys
Wie Webscraping-Proxys funktionieren
Verwenden Sie Proxy-Routing als eine kontrollierte Schicht in einem genehmigten öffentlichen Datensystem mit explizitem Umfang, Tempo, Validierung, Traffic-Budgets und Stoppbedingungen.
Schützen Sie die Identität Ihres Scrapers
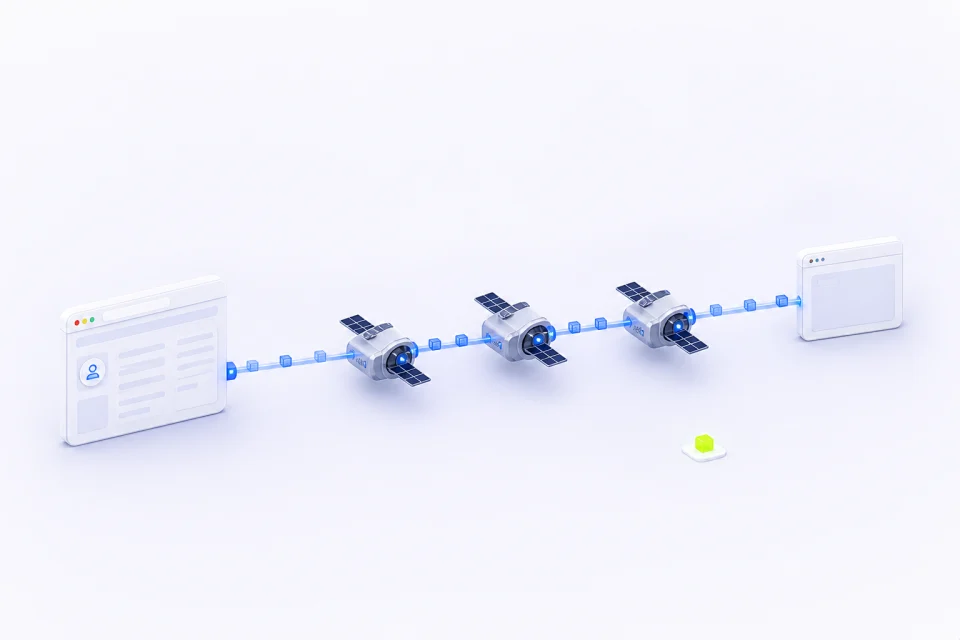
Ein Proxy hält die normale Netzwerkadresse des Sammlers außerhalb des genehmigten Anfragepfads auf der öffentlichen Seite und stellt eine dedizierte Proxy-Authentifizierung bereit.
IPMusk Fit: Halten Sie Proxy-Zugangsdaten, Quellkontodaten und sensible Seiteninhalte aus Protokollen und Screenshots heraus.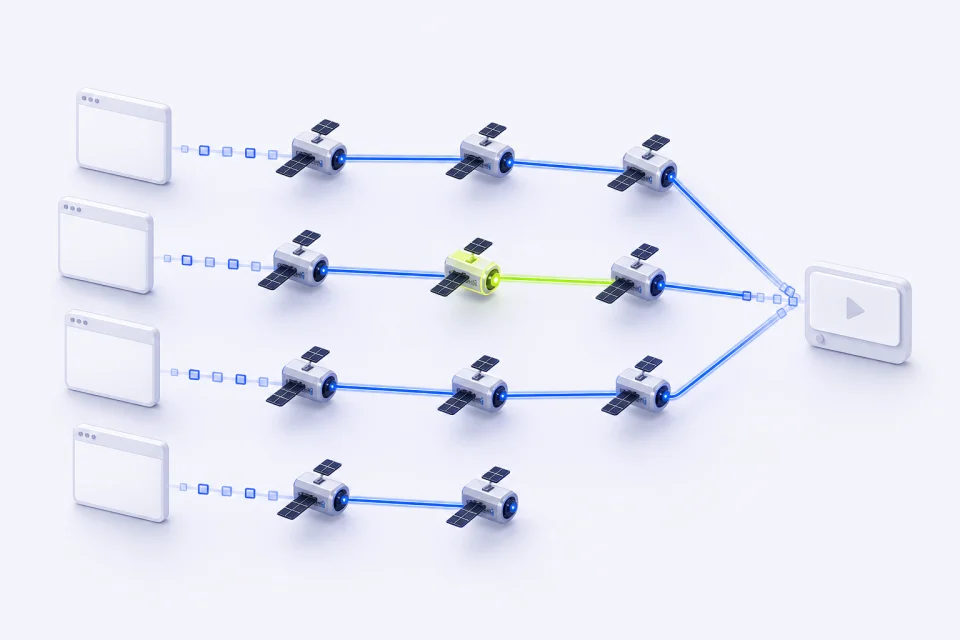
IPs über unabhängige Anfragen hinweg rotieren
Die Standardrotation trennt unabhängige URL- und Paginierungsanfragen in einem Job mit beschränkter Sammlung, anstatt jede Anfrage über eine einzige Adresse zu senden.
IPMusk-Passung: Setzen Sie konservative Nebenzeit, Tempo, Auszeiten, Wiederholungsobergrenzen und einen sofortigen Stopppfad ein.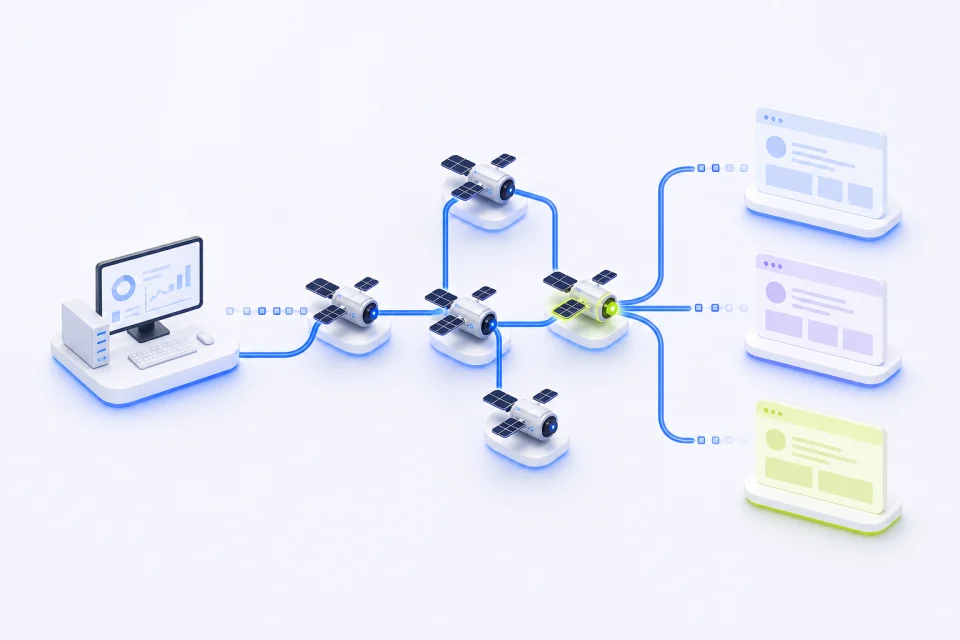
Zielspezifische Länder für lokalisierte Daten
Länderspezifische Routen helfen dabei, genehmigte öffentliche Preise, Kataloge, Suchseiten, Hinweise und regionale Inhalte zu vergleichen, wenn andere Browsereingaben weiterhin kontrolliert werden.
IPMusk-Eignung: Auswahl von Land und Bundesstaat; Stadt-, ASN- oder Anbieter-Targeting wird nicht angeboten.
Aufrechterhaltung der gemessenen Datenqualität
Der Antwortstatus allein reicht nicht aus: Validieren Sie erforderliche Felder, Seitenvorlagen, Länderzustand, Duplikate, Parser-Version und Quellzeitstempel, bevor Sie einen Datensatz akzeptieren.
IPMusk Fit: Misse nützliche Datensätze pro Datenmenge, nicht das rohe Anforderungsvolumen oder die Anzahl der Antworten.IPMusk Web Scraping-Proxy-Funktionen
Wie sich die Web-Scraping-Proxys von IPMusk hervorheben
Zwei klar getrennte Produkte behandeln rotierende Forschungsanfragen und stabile zugewiesene Adress-Workflows, ohne ihr Sitzungsverhalten oder Abrechnungsmodell zu mischen.
| Ausstattung | IPMusk | Beste Passform |
|---|---|---|
| Proxy-Optionen | Rotierende Residential Statischer ISP | Öffentliche Daten und stabile zugewiesene Umgebungen |
| Standortkontrolle | Länderebene Auswah | Regionale öffentliche Seitenvergleiche |
| Sitzungsverhalten | Standardrotation oder zugewiesene statische IP | Unabhängige Anfragen oder wiederholte Profile |
| Authentifizierung | Dedizierter Proxy-Benutzername und Passwort | Browser, Proxy-Clients und Server-Sammler |
| Planstruktur | Festgelegte GB-Pakete oder IP-Menge Laufzeit | Vorhersehbarer Traffic und Servicedauer |
Web-Scraping-Proxy-Pläne
Web-Scraping-Proxy-Pläne vergleichen
Nur verwenden, wenn eine autorisierte Quelle oder ein wiederholter Forschungspfad tatsächlich von einer zugewiesenen Netzwerkadresse über einen definierten Zeitraum profitiert. Verwenden Sie ihn für begrenzte öffentliche Seiten-Sammlungen, die unabhängige Anfragen auf Länderebene benötigen und auf übertragenem Traffic, Validierung und strikten Wiederholungsgrenzen basieren.
Rotierende Residential Proxies
Rotierende Residential Proxies ändern standardmäßig die Adressen zwischen den Verbindungen und verwenden feste GB-Pakete. Verwenden Sie sie für begrenzte öffentliche Seiten-Sammlungen, die unabhängige Anfragen auf Länderebene benötigen und auf übertragenem Traffic, Validierung und strikten Wiederholungsgrenzen basieren.
- Länderspezifische Zielauswahl aus geprüften Standorten
- Standardmäßige zufällige Rotation zwischen den Verbindungen
- Dedizierte Benutzername- und Passwortauthentifizierung
Statische ISP Proxies
Statische ISP Proxies bieten zugewiesene Adressen für ein gewähltes Land und die Servicelaufzeit. Verwenden Sie sie nur, wenn eine autorisierte Quelle oder ein wiederholter Forschungspfad tatsächlich von einer zugewiesenen Netzwerkadresse über einen definierten Zeitraum profitiert.
- Eine zugewiesene Adresse für die gewählte Laufzeit
- Stabile Netzwerkidentität für ein genehmigtes Profil
- Einzelne Verbindungsdetails für jede Ressource
Web-Scraping-Proxy-Einrichtung
So richten Sie Ihre Web-Scraping-Proxies ein
Wählen Sie das Produkt und das Land, generieren Sie die unterstützten Verbindungsdetails und validieren Sie dann eine genehmigte Seite oder einen Kunden, bevor Sie den Workflow erweitern.
Passe deine Proxy-Parameter an
Wählen Sie Rotating Residential oder Static ISP und wählen Sie ein verfügbares Land für den Web Scraping-Workflow. Für einen statischen ISP wählen Sie außerdem Menge und Laufzeit; für Residential wählen Sie das feste Traffic-Paket.
Erstellen Sie Ihre Proxy-Daten
Öffnen Sie den passenden Arbeitsbereich und generieren oder zeigen Sie die unterstützten Verbindungsdetails an. Halte Proxy-Zugangsdaten getrennt von Dashboard- und Zielkonto-Passwörtern.
Stecken Sie den Proxy in Ihren Stack ein
Füge die Verbindung dem genehmigten Browserprofil, Proxy-Client oder serverseitigem Collector hinzu. Teste eine Web-Scraping-Seite oder einen Workflow, bestätige Land und Antwort und skaliere dann innerhalb der schriftlichen Grenzen.
Web-Scraping-Proxy-FAQ
FAQs zu Web-Scraping-Proxys
Wählen Sie eine stabil zugewiesene Adresse für wiederholte Profile und Rotating-Residential-Zugang für begrenzte öffentliche Datenerhebung oder regionale Prüfungen.
Was ist ein Web-Scraping-Proxy?
Ein Web-Scraping-Proxy liefert eine weitere IP-Adresse an einen genehmigten Public-Page-Sammler. Es handelt sich um eine Netzwerkroute, kein vollständiger Scraper: Der Client besitzt weiterhin Quellcode-Scope, Pacing, Parsing, Validierung, Speicher und Löschung.
Welcher IPMusk-Proxy-Typ passt zum Web-Scraping?
Rotierende Residential-Proxies sind die normale Lösung für begrenzte öffentliche Seiten-Sammlungen über unabhängige Anfragen hinweg. Statische ISP-Proxies sind nur für einen autorisierten wiederholten Pfad erforderlich, der eine zugewiesene Adresse benötigt. IPMusk bietet keine mobilen Proxys an. Datacenter-Proxys sind ein eigenes Produkt für Websites, die Datacenter-Traffic akzeptieren: IPs von Hosting-Anbietern, keine Residential- oder ISP-Adressen.
Kann ich kostenlose Proxies für Web-Scraping verwenden?
Kostenlose geteilte Proxies sind oft instabil, stark genutzt und schwer zu prüfen. Authentifizierter Zugriff mit bekanntem Land, Traffic- oder Laufzeitbegrenzungen, Arbeitslastinhaber, Seitenumfang und Stopp-Regeln ist eine klarere Basis.
Wie helfen rotierende Proxies beim Scraping?
Sie ändern standardmäßig die Adressen zwischen den Verbindungen und können unabhängige Anfragen trennen. Sie ersetzen nicht vorsichtiges Tempo, Caching, Kontrolle der Antwortgröße, Validierung, begrenzte Wiederholungen oder eine Stoppbedingung bei Ablehnung und strukturellen Änderungen.
Werden Web-Scraping-Proxies CAPTCHAs umgehen?
Kein CAPTCHA-freies Ergebnis ist garantiert. Eine Herausforderung ist eine Quell-Antwort, die der Collector gemäß seinem genehmigten Protokoll klassifizieren und bearbeiten sollte, normalerweise mit einer strikten Wiederholungsobergrenze oder Stop, anstatt wiederholter Adressänderungen.
Können Proxies für die Sammlung öffentlicher Web-Daten verwendet werden?
Sie können die autorisierte Sammlung öffentlicher Felder innerhalb der Quellregeln und eines schriftlichen Umfangs unterstützen. Sie berechtigen nicht zum Zugriff auf private Bereiche, Authentifizierungsumgehung, Umgehung von Paywalls, Sammlung sensibler persönlicher Daten oder zur Ignorierung technischer Einschränkungen.
Weitere Proxy-Lösungen