Proxy de web scraping
Proxies Premium de Web Scraping
Residencial Rotativo · ISP Estático · Segmentação por país · Autenticação por credenciais
- Roteie coletores de páginas públicas aprovadas através de endereços proxy separados
- Roteie endereços através de URLs, páginas e cronogramas de atualização limitados
- Colete dados públicos localizados com segmentação por país
- Use um endereço atribuído quando uma base de referência repetida precisar de continuidade
Por que proxies de Web Scraping
O que é um Proxy para Web Scraping?
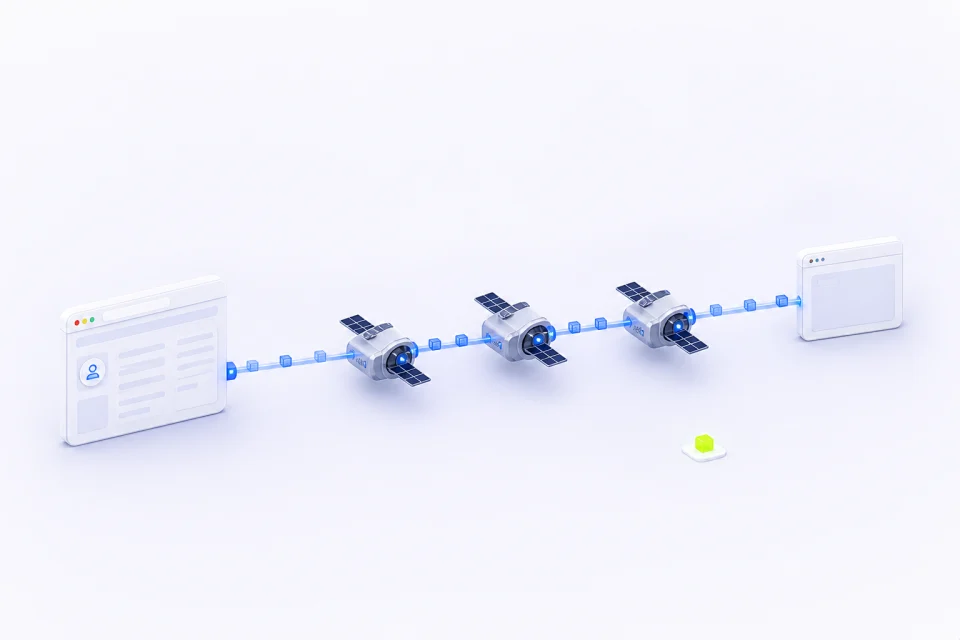
Um proxy para web scraping atua como intermediário entre um coletor aprovado e um site público. Ele fornece outro endereço IP para a solicitação em vez de usar o endereço de rede habitual do operador.
Uma equipe de dados da web pode usar roteamento por proxy para páginas públicas de produto, busca, categoria, diretório, artigo ou outras aprovadas quando os campos necessários, URLs, países, cadência de atualização e condições de parada forem definidos primeiro.
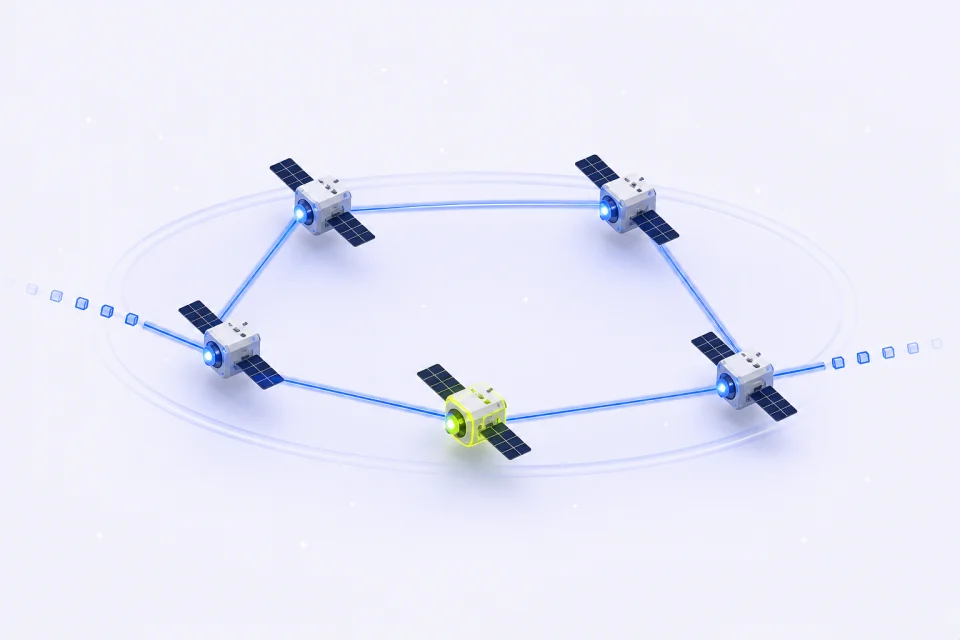
O acesso residencial rotativo se encaixa em coleta limitada que precisa de solicitações independentes em países disponíveis. O ISP Estático se encaixa em uma fonte autorizada que realmente se beneficia de um endereço atribuído em sessões repetidas.
Por exemplo, um coletor de preços pode solicitar uma lista de itens canônica por meio de rotas residenciais rotativas, validar todas as respostas e campos extraídos, armazenar em cache páginas inalteradas, parar em negações repetidas e colocar em quarentena modelos inesperados para revisão.
Casos de uso de proxy de Web Scraping
Como Funcionam os Proxies de Raspagem Web
Use o roteamento proxy como uma camada controlada em um sistema de dados públicos aprovado, com escopo explícito, ritmo, validação, orçamentos de tráfego e condições de parada.
Proteja a Identidade do Seu Raspador
Um proxy mantém o endereço normal de rede do coletor fora do caminho aprovado de solicitação de página pública e fornece autenticação dedicada por proxy.
Ajuste IPMusk: mantenha credenciais proxy, dados da conta de origem e conteúdo sensível da página fora dos logs e capturas de tela.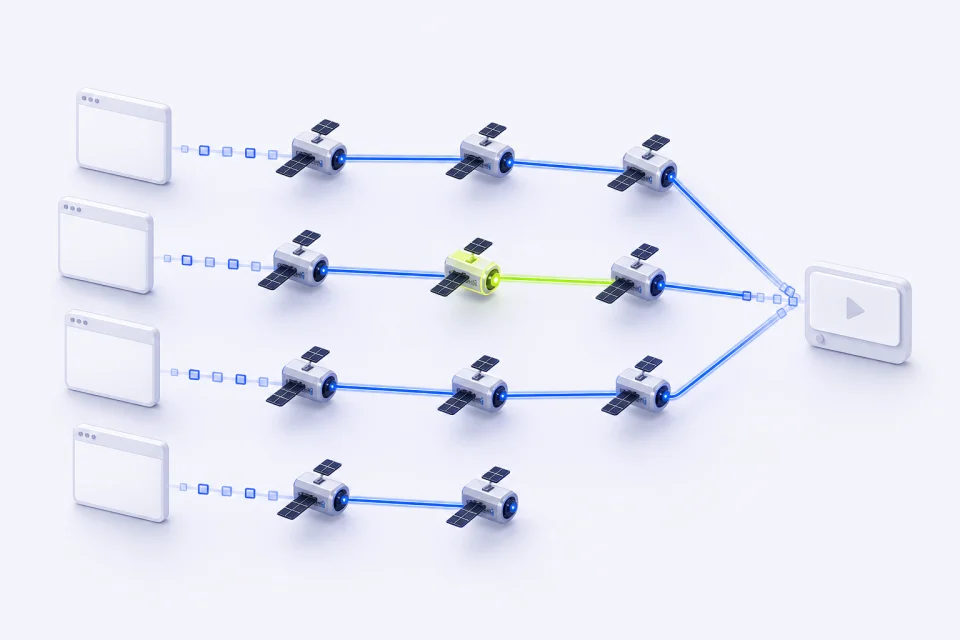
Rotacione IPs entre requisições independentes
A rotação padrão separa requisições independentes de URL e paginação em um trabalho de coleção limitada, em vez de enviar todas as requisições por um único endereço.
Ajuste IPMusk: defina concorrência conservadora, ritmo, tempos técnicos, tetos de tentativas e um caminho de parada imediata.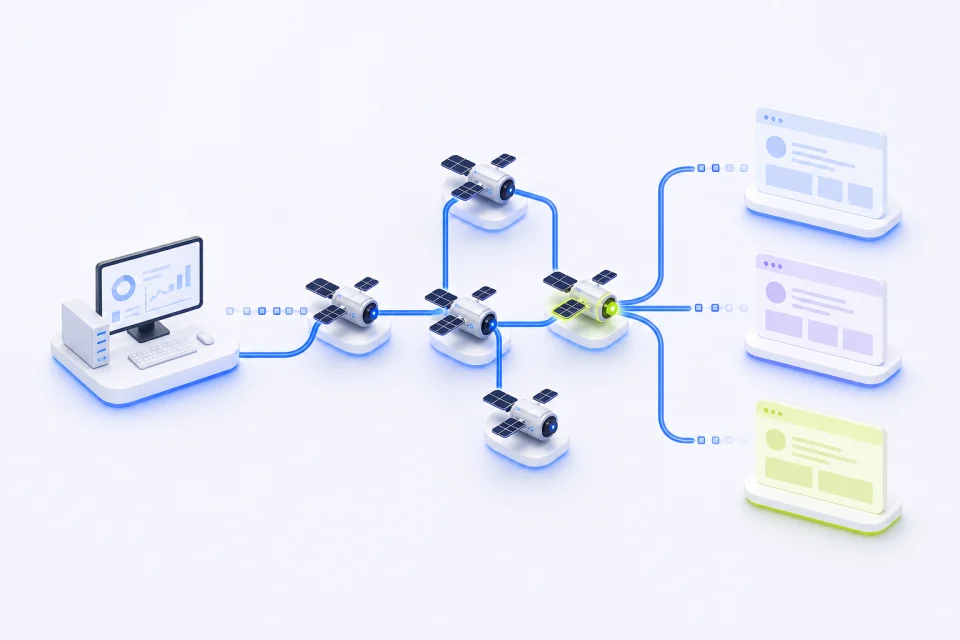
Destine Países Específicos para Dados Localizados
Rotas em nível de país ajudam a comparar preços públicos aprovados, catálogos, páginas de busca, avisos e conteúdos regionais quando outras entradas do navegador permanecem controladas.
Ajuste IPMusk: seleção por país e estado; segmentação por cidade, ASN ou operadora não é oferecida.
Manter a Qualidade dos Dados Medidos
O status da resposta sozinho não é suficiente: valide campos obrigatórios, modelos de página, estado do país, duplicatas, versão do parser e datas de data e datas de origem antes de aceitar um registro.
Ajuste IPMusk: mede registros úteis por unidade de tráfego, não o volume bruto de requisições ou a contagem de respostas.Recursos do proxy do Web Scraping do IPMusk
Como os proxies de web scraping do IPMusk se destacam
Dois produtos claramente separados cobrem requisições de pesquisa rotativas e fluxos de trabalho estáveis com endereços atribuídos, sem misturar seu comportamento de sessão ou modelo de faturamento.
| Característica | IPMusk | Melhor encaixe |
|---|---|---|
| Opções de proxy | ISP Residencial Estático Rotativo | Dados públicos e ambientes estáveis atribuídos |
| Controle de localização | Seleção em nível nacional | Comparações regionais de páginas públicas |
| Comportamento da sessão | Rotação padrão ou IP estático atribuído | Solicitações independentes ou perfis repetidos |
| Autenticação | Nome de usuário e senha do proxy dedicado | Navegadores, clientes proxy e coletores de servidores |
| Estrutura do plano | Pacotes GB fixos ou termo de quantidade IP | Tráfego e duração previsíveis do serviço |
Planos proxy de Web Scraping
Compare Planos Proxy de Web Scraping
Use-o apenas quando uma fonte autorizada ou um caminho de pesquisa repetido realmente se beneficiar de um endereço de rede atribuído ao longo de um período definido. Use-o para coleta de páginas públicas limitadas que exigem requisições independentes em nível de país e é projetado em torno de tráfego transferido, validação e limites rigorosos de retentativas.
Proxies Residenciais Rotativos
Proxies Residenciais rotativos mudam endereços entre conexões por padrão e usam pacotes GB fixos. Use-o para coleta de páginas públicas limitadas que exigem requisições independentes em nível de país e é projetado em torno de tráfego transferido, validação e limites rigorosos de retentativas.
- Segmentação em nível de país a partir de locais revisados
- Rotação aleatória padrão entre conexões
- Autenticação dedicada por nome de usuário e senha
Proxies estáticos de ISP
Proxies estáticos de ISP fornecem endereços atribuídos para um país e termo de serviço selecionados. Use-o apenas quando uma fonte autorizada ou um caminho de pesquisa repetido realmente se beneficiar de um endereço de rede atribuído ao longo de um período definido.
- Um endereço atribuído para o período selecionado
- Identidade de rede estável para um perfil aprovado
- Detalhes individuais de conexão para cada recurso
Configuração de proxy por Web Scraping
Como configurar seus proxies de web scraping
Escolha o produto e o país, gere os detalhes de conexão suportados e, em seguida, valide uma página ou cliente aprovado antes de expandir o fluxo de trabalho.
Personalize Seus Parâmetros de Proxy
Escolha ISP Residencial Rotativo ou ISP Estático e selecione um país disponível para o fluxo de trabalho de Web Scraping. Para ISP Estático, também escolha a quantidade e o prazo; para Residencial, escolha o pacote de tráfego fixo.
Gere Seus Detalhes de Proxy
Abra o workspace correspondente e gere ou revele os detalhes de conexão suportados. Mantenha as credenciais do proxy separadas das senhas do dashboard e da conta de destino.
Conecte o Proxy à Sua Stack
Adicione a conexão ao perfil de navegador aprovado, cliente de proxy ou coletor do lado do servidor. Teste uma página ou fluxo de trabalho de Web Scraping, confirme o país e a resposta e, em seguida, escale dentro dos limites escritos.
FAQ de proxy para Web Scraping
Perguntas Frequentes Sobre Proxies de Web Scraping
Escolha um endereço atribuído estável para perfis repetidos e acesso residencial rotativo para coleta de dados públicos delimitada ou verificações regionais.
O que é um proxy de web scraping?
Um proxy de web scraping fornece outro endereço IP a um coletor de páginas públicas aprovado. É uma rota de rede, não um raspador completo: o cliente ainda possui escopo de fonte, ritmo, análise, validação, armazenamento e exclusão.
Qual tipo de proxy IPMusk se adapta ao web scraping?
Rotating Residential é o ajuste normal para coleta de páginas públicas limitadas em solicitações independentes. ISP estático é apenas para um caminho repetido autorizado que precisa de um endereço atribuído. O IPMusk não oferece proxies móveis. Os proxies de datacenter são um produto separado para sites que aceitam tráfego de datacenter: IPs de provedores de hospedagem, não endereços residenciais nem de ISP.
Posso usar proxies gratuitos para web scraping?
Proxies gratuitos compartilhados costumam ser instáveis, muito reutilizados e difíceis de auditar. Acesso autenticado com país conhecido, limites de tráfego ou de termos, proprietário da carga de trabalho, escopo da página e regras de parada é uma linha de base mais clara.
Como proxies rotativos ajudam no scraping?
Eles mudam de endereço entre conexões por padrão e podem separar solicitações independentes. Eles não substituem a limitação conservadora de ritmo, caching, controle de tamanho de resposta, validação, tentativas limitadas ou uma condição de parada para negação e mudanças estruturais.
Proxies de web scraping irão contornar CAPTCHAs?
Nenhum resultado livre de CAPTCHA é garantido. Um desafio é uma resposta da fonte que o coletor deve classificar e tratar de acordo com seu protocolo aprovado, geralmente com um teto estrito de tentativas ou parada, em vez de repetidas mudanças de endereço.
Proxies podem ser usados para coleta de dados públicos na web?
Eles podem apoiar a coleta autorizada de campos públicos dentro das regras da fonte e de um escopo escrito. Eles não autorizam áreas privadas, bypass de autenticação, contorno de paywalls, coleta de dados pessoais sensíveis ou ignorar restrições técnicas.
Mais soluções de proxy